

Как устроена архитектура enterprise Data Catalog
Разбираем техническую архитектуру корпоративного каталога данных: из каких компонентов он состоит и как они взаимодействуют.
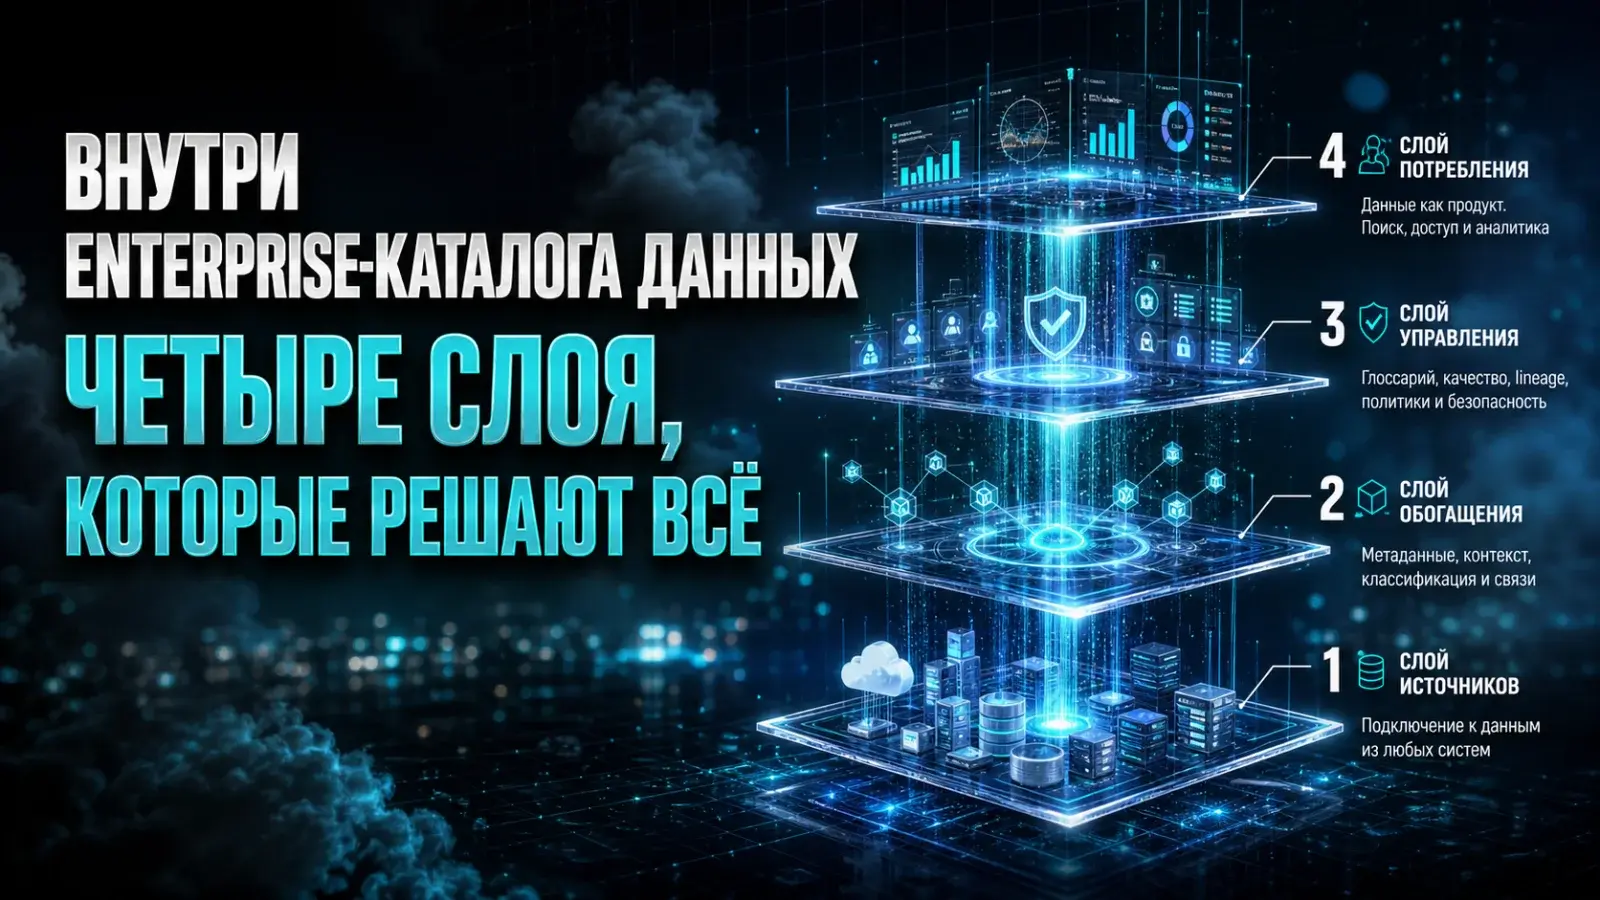
Когда ИТ-архитектор оценивает каталог данных перед покупкой, его интересует не маркетинговое описание, а конкретные технические компоненты: как система собирает метаданные, где их хранит и как масштабируется при росте числа источников. Разбираем типовую архитектуру enterprise-класса каталога данных.
Краткий вывод: архитектура зрелого корпоративного каталога данных строится из четырёх слоёв — коннекторы к источникам, хранилище метаданных, поисковый индекс и веб-интерфейс с API; качество каждого слоя определяет реальную производительность системы при масштабе.
Слой 1. Коннекторы к источникам данных
Первый компонент — набор адаптеров для подключения к разным источникам: реляционным и колоночным СУБД, файловым хранилищам, BI-платформам, ETL-инструментам. Чем шире набор готовых коннекторов, тем быстрее происходит внедрение без написания собственной интеграции.
Слой 2. Хранилище метаданных
Собранные метаданные — схемы, статистика, связи — сохраняются в отдельном хранилище, обычно построенном на графовой или реляционной базе данных. Именно здесь строятся связи для Data Lineage и хранится история изменений бизнес-глоссария.
Слой 3. Поисковый индекс
Для быстрого полнотекстового поиска по бизнес-терминам и техническим названиям используется отдельный поисковый индекс, часто на базе движков типа Elasticsearch. Скорость и релевантность поиска напрямую влияют на удобство работы аналитиков с каталогом.
Слой 4. Веб-интерфейс и API
Финальный слой — интерфейс для пользователей (поиск, карточки данных, глоссарий) и API для интеграции с внешними системами: BI-инструментами, системами управления доступом, инструментами мониторинга качества данных.
Как это влияет на выбор платформы
Продукты на базе открытых стандартов, например Arenadata Catalog на базе OpenMetadata, унаследуют проверенную архитектуру сообщества и получают готовую экосистему коннекторов, что снижает риски при внедрении по сравнению с полностью проприетарными решениями с закрытой архитектурой.
Часто задаваемые вопросы
Можно ли развернуть каталог данных полностью on-premise? Да, большинство российских enterprise-решений поддерживают локальное развёртывание для соответствия требованиям безопасности.
Как архитектура влияет на скорость сканирования новых источников? Чем более параллельной и асинхронной сделана обработка метаданных, тем быстрее каталог обновляется при подключении крупных источников без нагрузки на сами системы-источники.